// CATEGORÍA: IA & Robótica
Google Cloud Despliega TPU 8tx y TPU 8i Max: Arquitectura de Silicio Soberano y Agentes de Contexto Masivo
TL;DR / KEY POINTS
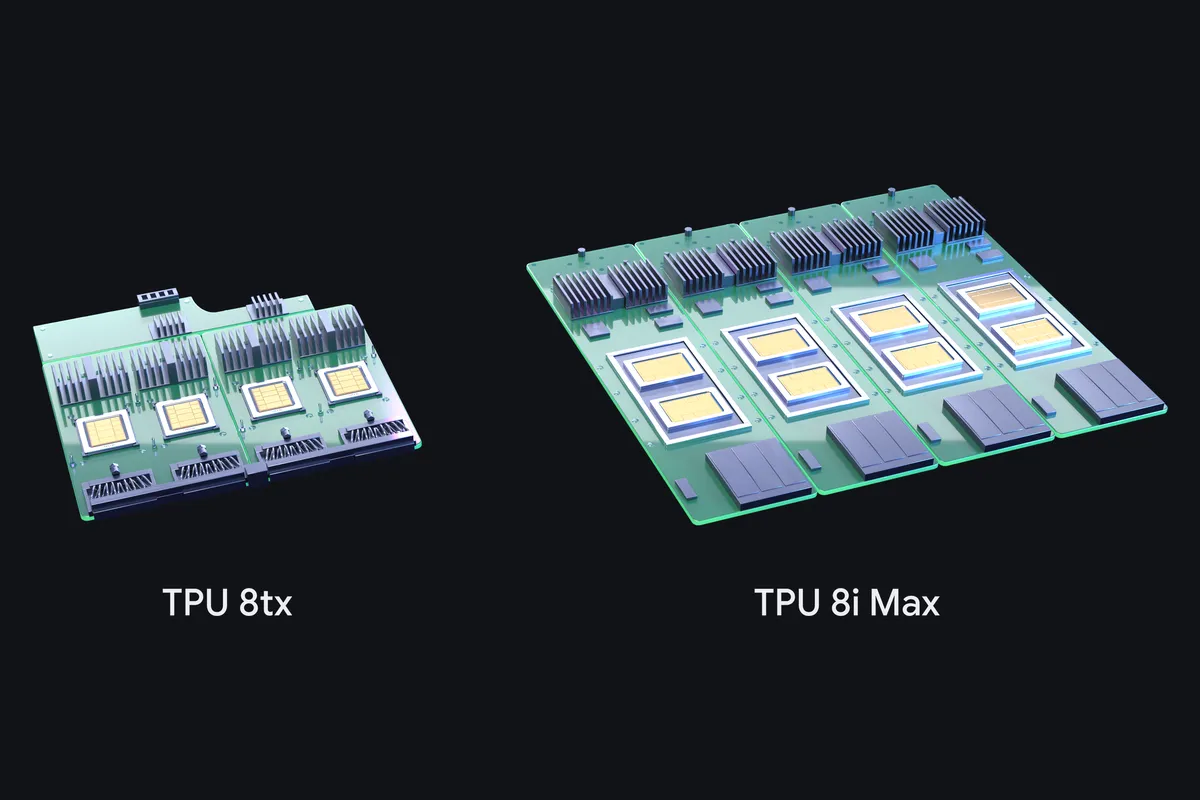
- Google Cloud completa un despliegue histórico de cuatro arquitecturas de silicio en 2026 tras presentar los aceleradores TPU 8tx y TPU 8i Max.
- El modelo TPU 8i Max duplica el ancho de banda a 17.2 TB/s e incrementa la memoria a 384 GB HBM, derribando el cuello de botella de memoria en flujos de trabajo agénticos multi-etapa.
- La variante TPU 8tx introduce computación confidencial nativa junto a procesadores host AMD EPYC de 5ª generación, reduciendo la latencia de inferencia protegida hasta en 2x frente a TPU 8t.
Ruptura de Paradigma: La Transición del Silicio Convencional a Sistemas Modulares
Google Cloud ejecutó un movimiento táctico decisivo en la guerra de la infraestructura de inteligencia artificial. Bajo el liderazgo de Amin Vahdat, vicepresidente sénior de IA e Infraestructura, la tecnológica anunció el lanzamiento oficial de TPU 8tx y TPU 8i Max. Con esta adición, Google consolida cuatro sistemas de unidades de procesamiento tensorial en un solo año fiscal (sumándose a TPU 8t y TPU 8i, presentados en abril), un hito operativo que responde a la demanda de cerca de 100 clientes de frontera, incluyendo laboratorios de investigación, entidades financieras y plataformas corporativas.
La estrategia marca una divergencia conceptual frente a los ciclos tradicionales de fundición: en lugar de esperar ciclos multi-anuales de desarrollo de nodo físico, Google ha aplicado una ingeniería a nivel de sistema. Al desacoplar y recombinar silicio existente mediante empaquetados avanzados y redes de interconexión Boardfly, la compañía optimiza el coste total de propiedad (TCO) y ataca de forma quirúrgica los dos puntos de fallo críticos en la computación actual: el aislamiento estricto de pesos/datos sensibles y el denominado "muro de la memoria".
TPU 8i Max: Demolición del Muro de Memoria en Agentes Autónomos
El paso de sistemas conversacionales a agentes autónomos multi-etapa ha expuesto la saturación de los aceleradores tradicionales al procesar contextos masivos de millones de tokens de forma persistente. La arquitectura del TPU 8i Max solventa este estrangulamiento mediante un diseño dual-die en un único empaquetado.
Métricas de Rendimiento y Densidad de Rack
- Capacidad de Memoria: Crece de 288 GB a 384 GB de memoria de alto ancho de banda (HBM), un incremento directo del 33% respecto a TPU 8i.
- Ancho de Banda HBM: Se duplica exactamente, escalando de 8.6 TB/s a 17.2 TB/s, lo que previene la degradación en operaciones continuas de lectura/escritura de KV-cache.
- Capacidad SRAM: El silicio integra una duplicación de memoria estática en chip, permitiendo retener activaciones intermedias críticas sin consultar memoria externa.
- Eficiencia Espacial: Mantiene la misma huella física por rack de centros de datos, maximizando la densidad de cálculo por vatio consumido.
Este salto permite que sistemas agénticos ejecuten razonamientos encadenados sobre código fuente corporativo masivo y bases de conocimiento vectoriales extensas sin incurrir en penalizaciones por latencia secuencial.
TPU 8tx: Silicio Soberano y Cómputo Confidencial sin Penalización Operativa
El segundo pilar del despliegue, el TPU 8tx, está diseñado para resolver las fricciones de adopción en sectores hiperregulados: banca de inversión, defensa e infraestructuras gubernamentales críticas. Ante la necesidad de procesar propiedad intelectual confidencial y pesos de modelos propietarios en entornos cloud compartidos, Google implementa confidential computing directamente a nivel de silicio.
Para materializar este estándar, Google integró sus matrices TPU con procesadores de servidor AMD EPYC de 5ª generación (Turin). Esta alianza de hardware orquesta entornos de ejecución confiables (TEE) donde el cifrado de datos opera tanto en reposo como en tránsito y durante la propia ejecución algorítmica. Frente a las implementaciones previas de TPU 8t, el TPU 8tx recorta la latencia a la mitad (2x más rápido) eliminando el clásico peaje computacional asociado a las capas criptográficas.
Implicaciones Geopolíticas y Presión Competitiva sobre NVIDIA
Con ingresos de Google Cloud superando los 30.710 millones de dólares en el trimestre de septiembre de 2026 impulsados por el silicio propio, el despliegue de TPU 8tx y 8i Max debilita el monopolio de facto de las arquitecturas cerradas basadas en GPUs comerciales. Al ofrecer compatibilidad directa con el ecosistema de desarrollo a través de extensiones nativas en PyTorch y su plataforma AI Hypercomputer, Google reduce la fricción de migración desde CUDA.
La posibilidad de desplegar estos aceleradores tanto en la nube pública de Google como en entornos locales e instalaciones de soberanía de datos otorga a las corporaciones una alternativa viable para contener costes operativos y mitigar dependencias en la cadena de suministro de hardware global.
¿Cómo evalúas este contenido?
Tus reacciones adaptan de inmediato el motor de recomendación neuronal en tiempo real sin cookies de terceros.

OPTIMIZACIÓN OPERATIVA CON GEMINI 3.8 FLASH Y CONTEXTO MASIVO
Micro-curso operativo: OPTIMIZACIÓN OPERATIVA CON GEMINI 3.8 FLASH Y CONTEXTO MASIVO